
產業分析
AI agent 為何帶動 CPU 需求-從運算分工到晶圓代工與具名供應鏈
當 AI 從回答問題,走向查資料、操作軟體、執行程式並反覆驗證結果,資料中心需要處理的工作也跟著改變。大型模型推論主要依賴 GPU 與 AI 加速器;模型所驅動的工具、程式與企業應用,則增加了 CPU、記憶體和輸入輸出系統的負擔。這正是「agent CPU」需求受到關注的原因。[1][2] 這波變化的產業意義,不只在於哪家 CPU 能賣得更多。不同品牌的處理器可能交由同一家晶圓廠製造,之後再經過不同的載板、封裝、測試與伺服器整合流程。從工作負載一路追到供應鏈,才能分辨需求成長可能落在哪裡,以及哪些關係已經獲得確認。
Agent CPU 是什麼
「Agent CPU」可理解為用來承擔 AI agent 工作負載的 CPU。它尚不是具有統一規格、獨立出貨統計與一致市占口徑的硬體分類。既有的 Intel Xeon、AMD EPYC 與各種 Arm 架構伺服器 CPU,都能參與 agent 系統;部分新產品則明確以 agent、工具執行及強化學習環境為設計與行銷重點。[1][2][3]
以程式開發 agent 為例,模型產生修改方案之後,系統還要建立隔離環境、讀寫檔案、執行編譯、跑測試,再把結果送回模型。這些步驟往往需要 CPU 實際執行。資料分析 agent 也會呼叫資料庫、處理資料、執行 Python,並檢查輸出格式。CPU 的角色因此涵蓋任務協調與真正的工作執行。[1][2]
模型推論與 CPU 執行通常交替發生,也可能同時服務大量任務。CPU 層若無法及時完成工作,整體回應時間便會拉長。相反地,若瓶頸是外部 API、儲存或網路等待,增加 CPU 未必有效。判斷需求時,必須看完整流程,不能只看 agent 的數量。
為什麼 CPU 需求會增加
首先,同一個使用者請求可能觸發多次工具操作。從「生成一段回答」變成「完成一項工作」,中間新增的程式、資料處理與驗證步驟,都可能消耗 CPU 時間。其次,企業部署會同時服務許多使用者,並維持多個容器或沙盒;並行量提高,會增加核心數、記憶體容量及頻寬需求。agent 的強化學習與評估,也需要反覆運行環境與檢查結果。[1][2][3]
這讓 CPU 運算層有機會獨立擴充。NVIDIA 已推出 Vera CPU 機櫃;AMD 也提出在 GPU 基礎設施旁擴建 CPU 伺服器層的架構。這些產品與方案反映出供應商正針對工具執行、資料處理及大量隔離環境配置硬體。[1][3]
不過,工作量增加不等於 CPU 顆數等比例增加。更快的單核心效能、更高核心密度、軟體最佳化與較高利用率,都可能吸收部分成長。每個 agent 也不必獨占一顆 CPU。因此,市場常見的 CPU 與 GPU 配比,應視為特定架構的觀察或預測,不能直接套用到所有資料中心。
競爭者增加 供應模式也不同
這個市場同時包含對外供應伺服器處理器的 Intel、AMD、NVIDIA、Arm 與 Ampere,以及替自家雲端服務設計 CPU 的 AWS、Microsoft、Google。前者透過系統廠、雲端業者或企業部署進入市場;後者的重要商業成果,往往呈現在雲端執行個體的成本與效能,而不是對外出售 CPU 的收入。[3][7][8][9][10]
Arm 也需要分開理解:Arm 架構與核心 IP 的授權是一種業務;以 Arm AGI CPU 品牌提供處理器,則是另一層角色。把所有採用 Arm 架構的 CPU 都算成 Arm 自有晶片出貨,會混淆設計、授權與供應的邊界。[8]
各家 CPU 由誰製造
下圖選取與目前討論密切相關的代表產品。製程欄以主要運算晶粒或官方產品製程描述為主;多晶粒封裝內的基底、I/O 等晶粒可能採用不同節點。Intel 18A、Intel 3 與台積電 N2、N3 等名稱,也不能只按數字大小直接判斷效能與密度。
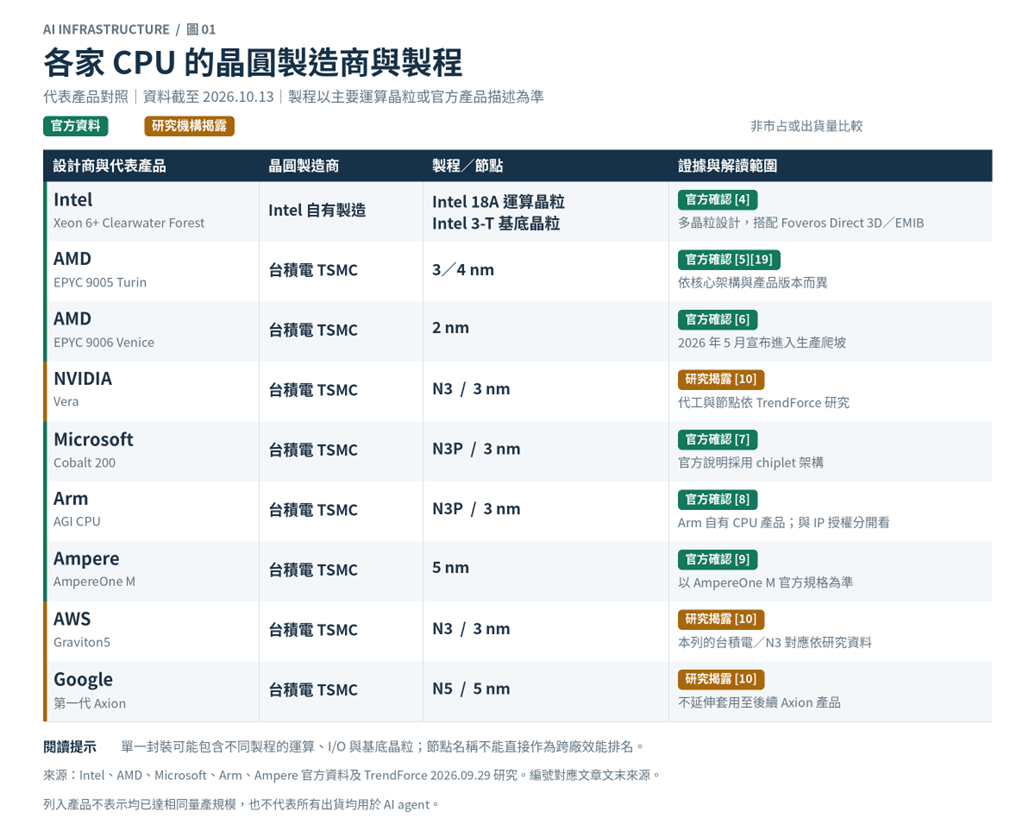
*圖一:代表產品的晶圓製造商與製程。綠色代表官方資料確認;橘色代表研究機構揭露。列入表格不表示產品已達相同量產規模,也不代表出貨全部用於 agent。*
Intel 的 Clearwater Forest 採用 Intel 18A,並結合 Intel 3-T 基底晶粒與 Foveros Direct 3D、EMIB 封裝技術,呈現自有製造及多晶粒整合的路線。AMD 則持續與台積電合作:EPYC 9005 採用 3/4 奈米製程,而 Venice 已由 AMD 宣布在台積電 2 奈米製程進入生產爬坡。[4][5][6][19]
Microsoft Cobalt 200 與 Arm AGI CPU 的官方資料都指向台積電 N3P;AmpereOne M 的官方規格則列出台積電 5 奈米。NVIDIA Vera、AWS Graviton5 與第一代 Google Axion 的台積電製程對應,可見於 TrendForce 的研究整理;這部分應保留研究來源標示,不能改寫成三家公司均已逐項正式公告。[7][8][9][10]
這形成一個值得注意的結構:CPU 品牌之間的競爭,可能同時增加同一家晶圓製造商承接的產品種類。但產品名單只能顯示供應關係,無法直接換算台積電或 Intel 在「agent CPU 晶圓」中的市占。還需要各產品的出貨量、晶粒面積、良率與實際用途,才能估算晶圓需求。
需求如何傳到上游與系統廠
從製造流程看,新增 CPU 需求會先影響晶片設計與晶圓投片,再傳到封裝載板、封裝及測試;完成的處理器還需要搭配記憶體、主機板、網路與儲存設備,最後整合成伺服器或機櫃。這些環節的需求不會完全同步,也不會具有相同的成長幅度。
例如,單顆 CPU 的核心數增加,不必然意味出貨顆數增加;晶粒變大、多晶粒數量增加或封裝更複雜,卻可能提高每顆處理器使用的矽面積與封裝資源。大量並行沙盒則可能先拉高記憶體容量與伺服器密度需求。這是供應鏈分析上的推論,實際結果仍取決於客戶採用的架構與採購數量。
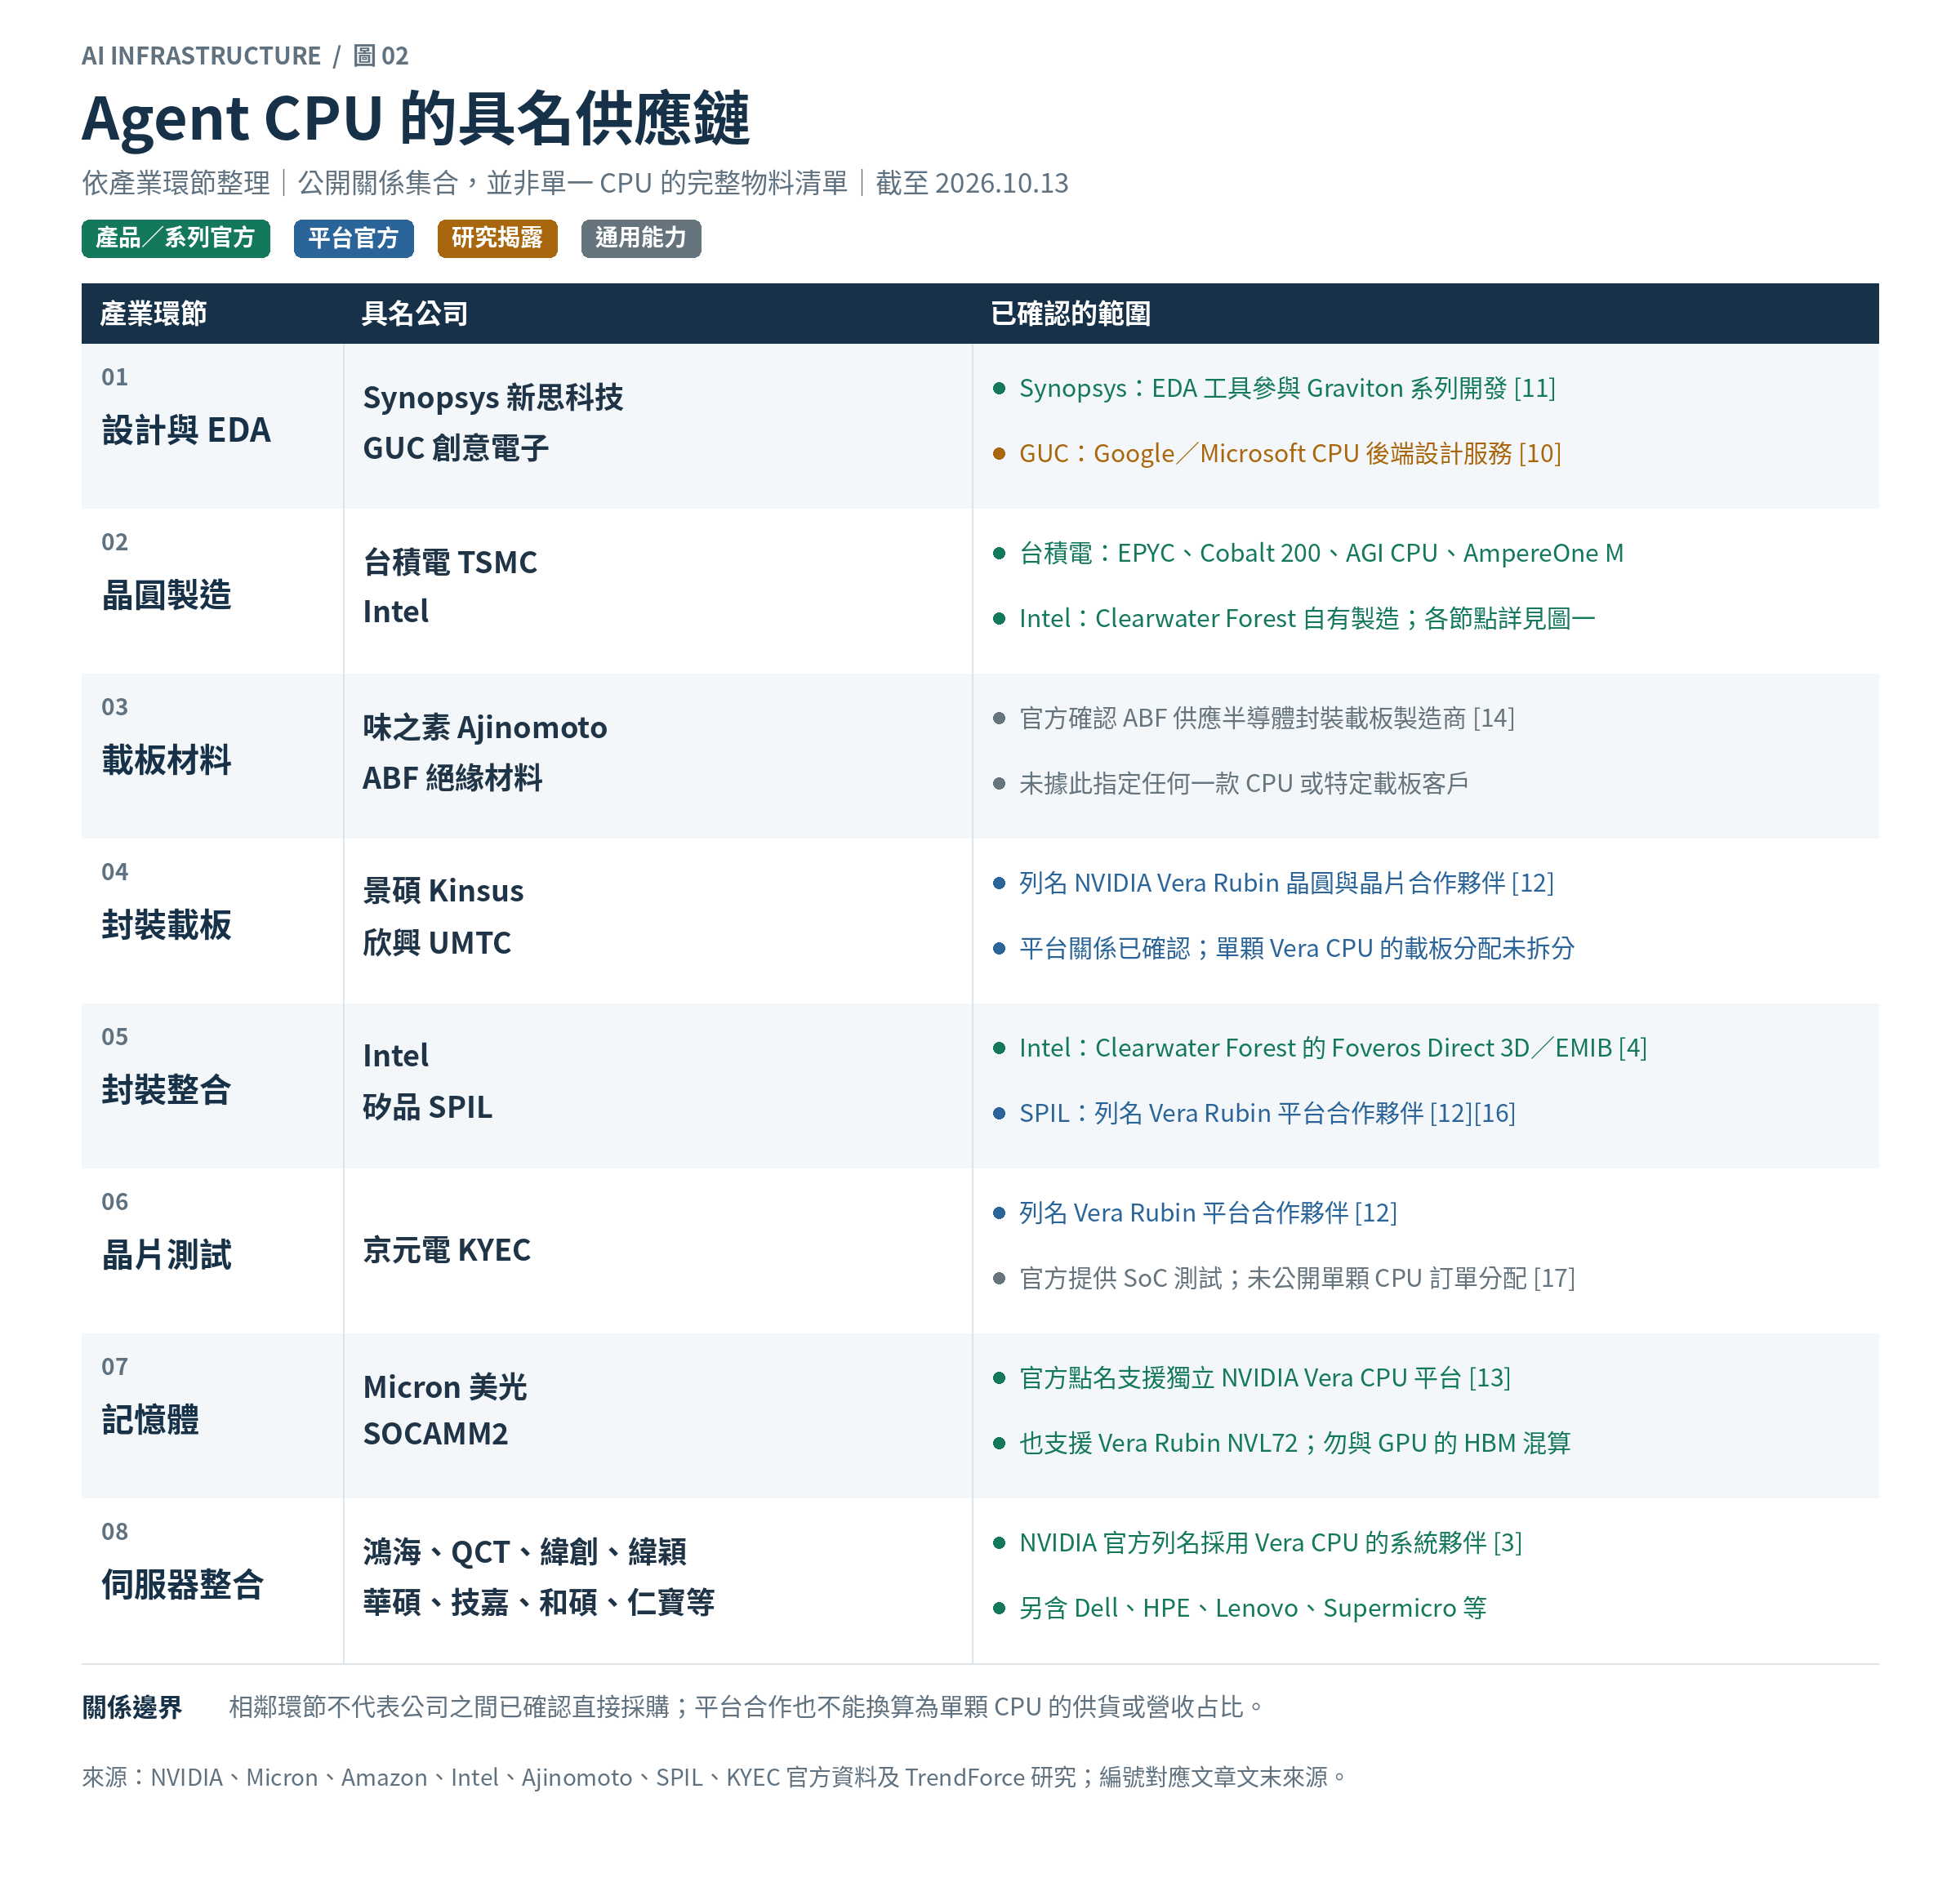
*圖二:依製造與系統環節整理的具名公司。這是不同產品與平台的公開關係集合,不是任何單一 CPU 的完整物料清單;上下相鄰也不表示彼此已有直接採購關係。*
具名供應鏈的四種證據
最直接的證據,是供應商明確指出某項產品服務哪個 CPU 或系統。例如 Micron 公告其 SOCAMM2 記憶體適用於 NVIDIA Vera Rubin NVL72,以及獨立 Vera CPU 平台。這比只說「供應 AI 記憶體」更能建立產品關聯。NVIDIA 也具名列出採用 Vera CPU 的系統夥伴,包括鴻海、QCT、緯創、緯穎、華碩、技嘉、和碩、仁寶,以及 Dell、HPE、Lenovo、Supermicro 等。[3][13]
第二種是平台層級的官方關係。NVIDIA 在介紹台灣 Vera Rubin 生態系時,列出台積電、矽品、景碩、京元電與欣興等晶圓及晶片合作夥伴。這足以確認它們參與該平台生態系;卻不能進一步斷言,景碩或欣興負責哪一顆 Vera CPU 的載板、矽品承接多少 CPU 封裝,或京元電取得多少特定型號測試訂單。[12]
第三種是產業研究揭露。TrendForce 指出,Google 與 Microsoft 的 CPU 後端設計服務由創意電子 GUC 承接。這可以列入供應鏈觀察,但來源層級應保留為研究機構揭露,不能延伸成每一代 Axion、Cobalt 都有相同分工或相同營收貢獻。[10]
第四種是通用產品能力。味之素的 ABF 是高效能半導體封裝載板使用的絕緣材料;景碩公開介紹 CPU/GPU 所使用的 FCBGA 載板;矽品提供 IC 封裝,京元電提供 SoC 測試。這些資料可以說明它們位於哪個製造環節,但單靠產品能力,還不足以證明某一型號的採購關係。[14][15][16][17]
設計工具也屬於供應鏈的一部分。AWS 公開資料提到 Synopsys 的 EDA 工具參與 Graviton、Nitro 與 Trainium 的開發。這是系列層級的合作證據,應與單一處理器的晶圓、封裝或記憶體供應分開理解。[11]
財報能證明什麼
財報可以協助判斷伺服器需求、產品組合與售價變化,卻未必能拆出 agent 用途。以 Intel 2026 年第二季財報為例,伺服器產品銷量年增 9%,平均售價年增 48%;公司將售價變化主要歸因於高階產品比重提高,需求導向的定價調整影響較小。這能支持伺服器業務增強的判斷,但不能把全部增幅歸因於 agent。[18]
要計算「agent CPU 出貨占比」,必須知道有多少 CPU 實際服務 agent,以及占比的分母究竟是出貨顆數、核心數、運算時數或營收。同一台伺服器還可能混合運行 agent、資料庫與一般雲端工作。沒有一致定義與用途拆分,就不能把伺服器 CPU 市占、x86 市占、Arm 採用率或雲端客戶滲透率,換成 agent CPU 市占。
同樣地,供應鏈被具名確認,也不等於營收占比已經公開。要從主題走到財務估算,仍需追蹤量產時程、客戶採購規模、每套系統的零組件配置、單價及供應商分配比例。
下一個觀察重點是工作量與量產規模
AI agent 為 CPU 帶來的機會,來自模型周邊真實工作量的增加:程式需要執行、資料需要處理、工具需要協調,結果也需要驗證。對 CPU 設計商而言,競爭重點是以多少成本、功耗與延遲完成這些工作;對晶圓與後段供應鏈而言,則是哪些產品真正放量,以及每顆晶片、每套系統需要多少製造資源。
目前可辨識的製造關係,顯示台積電承接多個 CPU 品牌與雲端自研產品,Intel 則保有自有製造路線;台灣的載板、封測與系統廠也已在部分平台公告中被具名。接下來最有判斷力的訊號,將是可持續的部署量、量產交付與可核對的供應商收入,而不只是產品是否冠上 agent 名稱。
資料來源與備註
- [1] AMD,〈Agentic AI Changes the CPU/GPU Equation〉,2026-05-07。https://www.amd.com/en/blogs/2026/agentic-ai-changes-the-cpu-gpu-equation.html
- [2] Raj 等,〈Towards Understanding, Analyzing, and Optimizing Agentic AI Execution: A CPU-Centric Perspective〉,2025-11-01 首次提交、2026-04-16 修訂,研究預印本。https://arxiv.org/abs/2511.00739
- [3] NVIDIA,〈NVIDIA Launches Vera CPU, Purpose-Built for Agentic AI〉,2026-03-16。https://nvidianews.nvidia.com/news/nvidia-launches-vera-cpu-purpose-built-for-agentic-ai
- [4] Intel,〈Kevin O’Buckley Talks Progress on Intel 18A〉,Clearwater Forest 製程與封裝說明。https://www.intel.com/content/www/us/en/newsroom/news/kevin-obuckley-talks-progress-intel-18a.html
- [5] AMD,〈5th Gen AMD EPYC Processor Architecture〉,文件 70353,2025-03-17,Rev. B。https://docs.amd.com/v/u/en-US/5th-gen-amd-epyc-processor-architecture-white-paper
- [6] AMD,〈AMD Announces Production Ramp of Next-Generation AMD EPYC Processor Venice on TSMC 2nm Process Technology〉,2026-05-21。https://newsroom.amd.com/news/amd-announces-production-ramp-of-next-generation-a/
- [7] Microsoft Azure,〈New Azure Cobalt 200 VMs deliver 50% performance improvement, fully optimized for modern agentic AI workloads〉,2026-06-02。https://azure.microsoft.com/en-us/blog/new-azure-cobalt-200-vms-deliver-50-performance-improvement-fully-optimized-for-modern-agentic-ai-workloads/
- [8] Arm,〈The agentic inflection point and how Arm AGI CPU powers the next phase of AI infrastructure〉,2026-05-15。https://developer.arm.com/community/arm-community-blogs/b/ai-blog/posts/the-agentic-inflection-point-and-how-arm-agi-cpu-powers-the-next-phase-of-ai-infrastructure
- [9] Ampere,〈AmpereOne M Product Brief〉。https://amperecomputing.com/briefs/ampereone-m-product-brief
- [10] TrendForce,〈Not Just GPUs: Agentic AI Brings CPUs Back〉,2026-09-29;製程及 GUC 關係為研究機構揭露。https://www.trendforce.com/insights/agentic-ai-cpu-gpu
- [11] Amazon,〈AWS Graviton5 chip now generally available〉,含 Synopsys 合作說明。https://www.aboutamazon.com/news/aws/aws-graviton-5-cpu-amazon-ec2
- [12] NVIDIA,〈Taiwan’s Industry Titans Turbocharge World’s AI Infrastructure Buildout With NVIDIA〉,2026-05-31。https://blogs.nvidia.com/blog/taiwan-ecosystem-ai-infrastructure/
- [13] Micron,〈Micron in High-Volume Production of HBM4 Designed for NVIDIA Vera Rubin, PCIe Gen6 SSD and SOCAMM2〉,2026-03-16。https://investors.micron.com/news/press-release/2026/Micron-in-High-Volume-Production-of-HBM4-Designed-for-NVIDIA-Vera-Rubin-PCIe-Gen6-SSD-and-SOCAMM2-03-16-2026/default.aspx
- [14] Ajinomoto,〈Our Technologies〉,Electronic Materials 章節。https://www.ajinomoto.com/innovation/rd-organizations-and-facilities/bioscience_chemicals/technology
- [15] 景碩科技,產品介紹,FCBGA 章節。https://www.kinsus.com.tw/zh-tw/product/products/products_overview
- [16] SPIL,〈IC Packaging〉。https://spil.com.tw/IC_Packaging
- [17] KYEC,〈System on Chip〉。https://www.kyec.com.tw/en/Solution/system-on-chip-soc
- [18] Intel,2026 年第二季 Form 10-Q,Management’s Discussion and Analysis,頁 30。https://www.sec.gov/Archives/edgar/data/50863/000005086326000157/intc-20260627.htm
- [19] AMD,〈TSMC empowers semiconductor fabrication expansion with AMD〉,文中確認台積電為 EPYC 系列製造夥伴。https://www.amd.com/en/resources/case-studies/tsmc.html